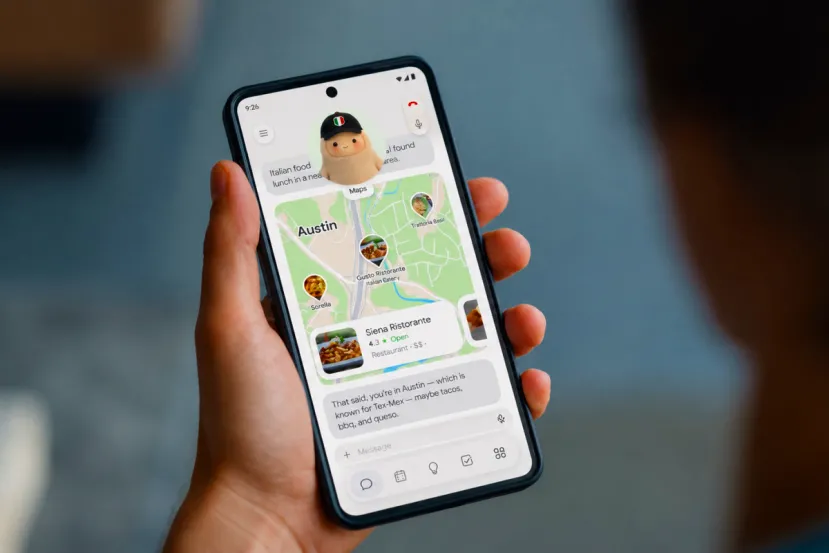
Meta ha comenzado a desplegar las conversaciones por voz con avatares animados en Muse. El asistente puede responder mientras un personaje mueve el rostro y los labios de acuerdo con lo que dice. El estreno está limitado inicialmente a Estados Unidos y abarca las versiones para móviles, la web y Mac.
El anuncio convierte en una función de uso cotidiano una tecnología que la compañía había explicado en septiembre. Muse Realtime Voice genera la respuesta hablada y Muse Realtime Avatar produce la animación. La novedad de noviembre es el inicio de su distribución entre los usuarios, con opciones para conversar únicamente mediante audio o incorporar también la imagen del personaje.
Conversaciones que se pueden interrumpir
La función se abre desde el icono del teléfono situado en la parte superior de Muse. Una vez iniciada, el usuario puede hablar con el asistente y cortarlo si necesita corregir una pregunta o cambiar de tema. La conversación no exige esperar a que termine cada respuesta para intervenir.
Meta permite elegir distintas voces y estilos. Quien active un avatar podrá mantenerlo junto al chat o llevarlo a pantalla completa. El personaje también reacciona mientras escucha, de modo que la animación continúa durante los turnos del usuario.
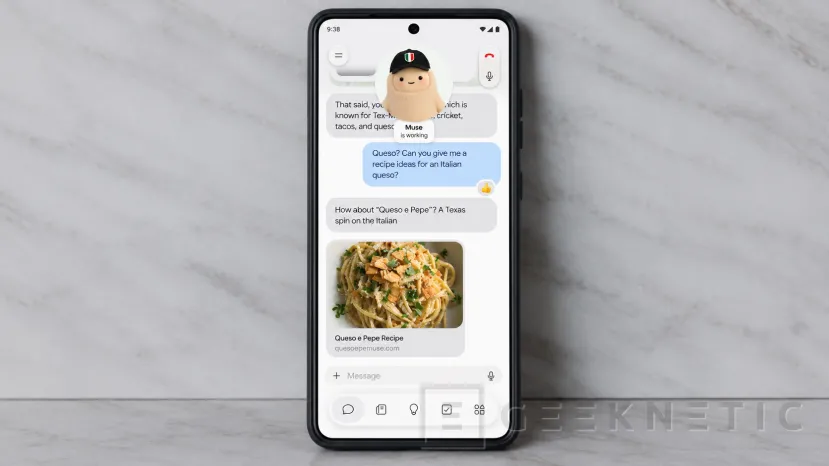
La empresa plantea usos como preparar una entrevista o comentar ideas mientras se trabaja con el asistente. Son ejemplos de interacción, sin que el anuncio aporte una evaluación independiente sobre la calidad de las respuestas o la utilidad del avatar en esas tareas.
La elección entre voz y vídeo cambia cómo se presenta la conversación. El usuario puede prescindir del personaje si solo necesita escuchar al asistente. La animación añade expresiones y una representación visual del turno de palabra, pero no aporta por sí misma una comprobación de lo que responde el modelo.
Cómo se coordinan la voz y los movimientos del avatar
Según la documentación técnica de Meta, la generación de voz produce una secuencia que recoge información del habla, incluida su entonación. Tanto la reproducción del audio como el sistema de animación utilizan esa información para mantener coordinada la respuesta.
El modelo de vídeo recibe una imagen de referencia del personaje, la información de voz y fotogramas recientes. Con esos datos genera fragmentos sucesivos de animación. Trabajar con fragmentos permite empezar a reproducir la respuesta sin esperar a que esté terminada una secuencia completa.
La documentación describe una salida de 448 × 768 píxeles a 25 fotogramas por segundo. La cifra de latencia publicada es de aproximadamente 870 milisegundos hasta el primer fragmento audiovisual de respuesta. Se refiere al comienzo de la reproducción, y no al tiempo necesario para completar toda la contestación.
Ese valor tampoco debe interpretarse como un tiempo garantizado para cualquier conversación. Es una medida técnica del sistema descrito por Meta. El anuncio del despliegue no incluye pruebas que permitan comparar la experiencia en diferentes dispositivos y conexiones.
El despliegue llega después de la presentación técnica
La separación entre ambos anuncios ayuda a precisar qué cambia ahora. En septiembre, Meta publicó información sobre cómo genera las voces y los avatares en tiempo real. En noviembre, anuncia que empieza a poner esas capacidades a disposición de los usuarios de Muse.
Las especificaciones de vídeo y la cifra de latencia pertenecen a aquella documentación. No se presentan como una mejora de rendimiento anunciada junto a la nueva función. La comunicación actual se centra en el acceso y en las formas de conversar con el asistente.
Meta también menciona futuros dispositivos relacionados con Muse, pero no fija su disponibilidad dentro de este estreno. Por ahora, las plataformas confirmadas para estas conversaciones son el móvil, la web y Mac.
El alcance geográfico sigue siendo una limitación relevante para quien quiera probarlo desde España. La empresa sitúa el comienzo de la distribución en Estados Unidos y no concreta una fecha de llegada a otros mercados. El anuncio tampoco permite dar por disponibles todas las combinaciones de voces y avatares para todas las cuentas desde el primer día.
Fin del Artículo. ¡Cuéntanos algo en los Comentarios!